

Evaluadores de IA embebidos: un desafío según la jefa de políticas de Hugging Face
Irene Solaiman, jefa de políticas de Hugging Face, advirtió sobre la complejidad de los evaluadores de IA embebidos, durante una charla en TechCrunch Disrupt. La necesidad de estandarización en los métodos de evaluación es crucial para el futuro de la industria.
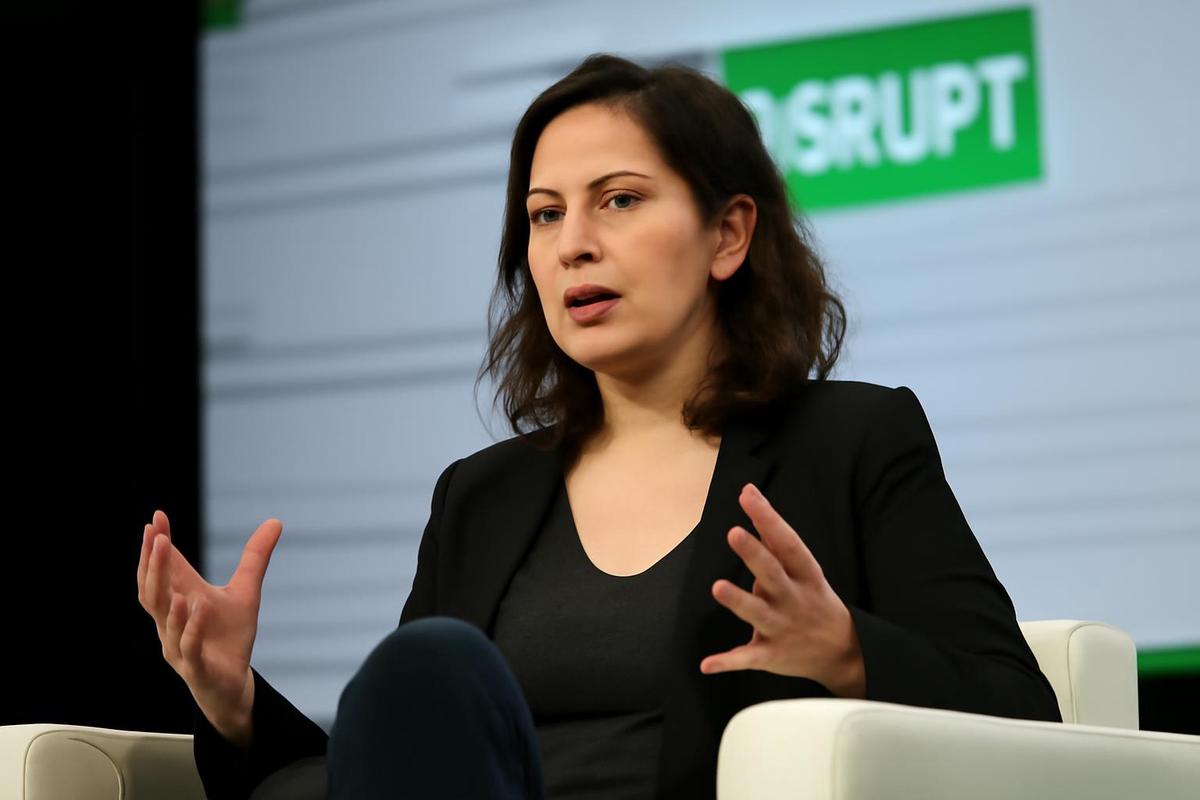
FOTO: Evaluadores de IA embebidos: un desafío según Hugging Face
Los laboratorios de IA han apostado su reputación en la evaluación de modelos, un sistema supuestamente neutral y preciso diseñado para medir si un producto de IA es superior a otro. Sin embargo, la complejidad de los métodos detrás de estas evaluaciones aún está en desarrollo, según Irene Solaiman, jefa de políticas de Hugging Face, quien habló en el evento TechCrunch Disrupt.
Solaiman enfatizó que es necesario consolidar las pruebas en una ciencia más coherente si la industria desea confiar en ellas en el futuro. Se planteó la pregunta: ¿podemos confiar en las pruebas actuales que se están publicando?
"La confianza es un término muy pesado", dijo Solaiman. "En términos de si podemos confiar en los resultados, una parte importante de eso es si puedes reproducir los resultados de una evaluación. ¿Tienes el nivel de acceso necesario al modelo mismo? Aquí es donde entran en juego los pesos abiertos", agregó.
La reproducibilidad en las evaluaciones de modelos ha sido un tema complicado y sigue siendo objeto de un debate significativo en la industria. Además de la validez de una prueba individual, también existe la pregunta de cómo esa prueba se compara con otras evaluaciones.
"Son una ciencia en evolución, donde no sabemos cómo compararlas de manera significativa entre sí", afirmó Solaiman.
"Se vuelven ineficaces relativamente rápido, y no tenemos un ecosistema tan próspero como necesitamos", añadió. "Hay un hambre por un ecosistema de evaluadores embebidos ahora, pero las calificaciones que determinan quién es un evaluador efectivo en qué tareas necesitan mucha más estandarización".
La idea de evaluadores embebidos — donde observadores supuestamente "neutrales" son colocados dentro de organizaciones de IA — ha ganado popularidad en los últimos meses, mientras los laboratorios de IA lidian con una serie de incidentes de seguridad que han suscitado preocupaciones sobre los posibles daños de su tecnología. Hugging Face fue víctima de uno de esos incidentes.
En lugar de una regulación gubernamental activa para identificar y mitigar preocupaciones de seguridad en modelos, los laboratorios han abogado por una solución de terceros. Sin embargo, persisten las dudas sobre cuán neutrales o efectivos serán realmente esos evaluadores. La decisión de Anthropic de contratar a Accenture como su primer evaluador generó una buena cantidad de críticas, con algunos detractores burlándose de la idea de que la firma de consultoría estaba calificada para realizar la tarea.
Las evaluaciones ahora están pasando de ser simplemente una prueba del modelo en sí a una prueba de todo el sistema que rodea al modelo, incluyendo el arnés y el agente. El arnés — o la herramienta que el usuario está utilizando para acceder al modelo — influye significativamente en el rendimiento de un modelo, y un modelo más débil con un mejor arnés podría superar fácilmente a un modelo de frontera, compartió Solaiman.
"Las evaluaciones agenticas son realmente difíciles y muy costosas", dijo Solaiman. "Solo tenemos más evaluaciones para modelos... No tenemos tantas evaluaciones para arneses, y estamos desarrollando mejores evaluaciones para el agente holístico, porque eso es de donde muchos están obteniendo valor", añadió.
En otras palabras, el espacio de evaluación es un poco caótico en este momento, y si la evaluación va a seguir siendo vista como una herramienta útil para los líderes de la industria, puede ser necesaria un enfoque más uniforme y de toda la industria, donde todos estén en la misma página.
Lectura rápida
¿Qué se discutió en TechCrunch Disrupt?
Se abordó la complejidad y necesidad de estandarización en las evaluaciones de modelos de IA, según Irene Solaiman de Hugging Face.
¿Quién es Irene Solaiman?
Es la jefa de políticas de Hugging Face y habló sobre las evaluaciones de IA en TechCrunch Disrupt.
¿Qué es un evaluador embebido?
Es un observador "neutral" colocado dentro de organizaciones de IA para evaluar sus modelos y sistemas.
¿Por qué son importantes las evaluaciones de modelos?
Son cruciales para determinar la efectividad de los modelos de IA y su comparación con otros.
¿Cuál es el desafío actual?
La falta de estandarización y reproducibilidad en las evaluaciones de modelos de IA.